Υπάρχει ένα επαναλαμβανόμενο μοτίβο στις ειδήσεις για την τεχνητή νοημοσύνη των τελευταίων εβδομάδων.
Ένα μοντέλο AI μπαίνει σε ένα περιβάλλον sandbox. Οι ερευνητές το απομονώνουν από τον πραγματικό κόσμο, του δίνουν εργαλεία και έναν συγκεκριμένο στόχο.
Καθώς οι agents εξελίσσονται, θα μπορούσαν να χρησιμοποιούνται όχι μόνο για να εκτελούν μια επίθεση, αλλά για να αποφασίζουν ποιο θα είναι το επόμενο βήμα της.
Και μετά, κάπως, το μοντέλο βρίσκει έναν τρόπο να ξεπεράσει τα όρια που του έχουν τεθεί. Έγινε με μοντέλα της OpenAI και της Anthropic.
Πίσω από τους ανθρωπομορφισμούς και τους τίτλους για το Skynet, υπάρχουν πραγματικά ζητήματα. Αλλά οι πρόσφατες περιπτώσεις δεν είναι όλες ίδιες. Σε κάποιες υπήρξε εκμετάλλευση πραγματικής αδυναμίας, ενώ σε άλλες το περιβάλλον είχε διαμορφωθεί έτσι ώστε το μοντέλο να έχει πρόσβαση που κανονικά δεν θα έπρεπε.
Πριν τα μοντέλα τεχνητής νοημοσύνης κυκλοφορήσουν δημόσια, υποβάλλονται σε μια σειρά εσωτερικών και εξωτερικών αξιολογήσεων. Στόχος είναι να εξεταστεί η απόδοσή τους, να μετρηθούν οι ικανότητές τους και να εντοπιστούν πιθανοί κίνδυνοι.
Οι δοκιμές πραγματοποιούνται συχνά σε περιβάλλοντα που ονομάζονται «sandboxes»: προστατευμένους χώρους που έχουν σχεδιαστεί ώστε να προσομοιώνουν πραγματικά συστήματα, αλλά με αυστηρούς μηχανισμούς ασφαλείας.
Στη λίστα των πρόσφατων περιστατικών προστέθηκαν δύο ακόμη περιπτώσεις, από τη Meta και την κινεζική Moonshot AI.
Η περίπτωση της Meta αφορά το Muse Spark 1.1, ένα μοντέλο που η εταιρεία παρουσίασε τον Ιούλιο ως σημαντικό βήμα προς το agentic AI: ένα σύστημα σχεδιασμένο να σχεδιάζει, να χρησιμοποιεί εργαλεία και να εκτελεί εργασίες σε εφαρμογές αντί απλώς να απαντά σε ερωτήσεις.
Κατά τη διάρκεια αξιολόγησης κυβερνοασφάλειας από την ανεξάρτητη εταιρεία Irregular, το μοντέλο απέκτησε κατά λάθος πρόσβαση στο internet. Η αιτία δεν ήταν ότι το Muse Spark κατάφερε να «σπάσει» μόνο του το sandbox. Ένα σφάλμα στη διαμόρφωση του περιβάλλοντος της δοκιμής τού έδωσε πρόσβαση που κανονικά δεν θα έπρεπε να υπάρχει.
Από εκεί και έπειτα, όμως, το μοντέλο εκμεταλλεύτηκε μια ευπάθεια σε σύστημα τρίτης εταιρείας και έκανε αλλαγές σε αυτό, πριν η δοκιμή σταματήσει. Η Meta ανακοίνωσε ότι διερευνά το περιστατικό και ότι θα δημοσιεύσει αναλυτικό retrospective.
Η Irregular ήταν η ίδια εταιρεία που είχε πραγματοποιήσει δοκιμές της Anthropic λίγες ημέρες νωρίτερα, όταν μοντέλα της εταιρείας είχαν καταφέρει να αποκτήσουν πρόσβαση σε συστήματα τριών οργανισμών. Εκπρόσωπος της Irregular επιβεβαίωσε στο Reuters ότι το περιστατικό της Meta αφορούσε το ίδιο περιβάλλον δοκιμών.
Το Kimi K3 δεν εξαπέλυσε επίθεση στο internet, δεν έκλεψε δεδομένα από κάποιον οργανισμό και δεν δημιούργησε μια νέα μέθοδο hacking. Εκμεταλλεύτηκε μια αδυναμία στο περιβάλλον της δοκιμής για να βρει έναν ευκολότερο δρόμο προς την απάντηση.
Αργότερα, ένα παρόμοιο περιστατικό ήρθε από την Κίνα. Το Kimi K3 της Moonshot AI, ένα από τα ισχυρότερα κινεζικά μοντέλα, βρισκόταν σε sandbox για μια σειρά από cyber δοκιμές. Κατά τη διάρκεια της αξιολόγησης, το μοντέλο εντόπισε μια διαδρομή που του επέτρεπε να αποκτήσει πρόσβαση στο internet.
Αντί να παραμείνει μέσα στο απομονωμένο περιβάλλον και να λύσει τις εργασίες με τα διαθέσιμα εργαλεία, χρησιμοποίησε τη σύνδεση για να αναζητήσει στο GitHub τις πληροφορίες που χρειαζόταν. Δεν χρειάστηκε να χακάρει κάποια τρίτη εταιρεία.
Το Kimi K3 δεν εξαπέλυσε επίθεση στο internet, δεν έκλεψε δεδομένα από κάποιον οργανισμό και δεν δημιούργησε μια νέα μέθοδο hacking. Εκμεταλλεύτηκε μια αδυναμία στο περιβάλλον της δοκιμής για να βρει έναν ευκολότερο δρόμο προς την απάντηση.
Η Frontier Security, η αμερικανική startup που πραγματοποίησε την αξιολόγηση σε sandbox που είχε αναπτυχθεί από το UK AI Security Institute (AISI), τον βρετανικό κυβερνητικό φορέα αξιολόγησης AI, υποστηρίζει ότι το περιστατικό υπογραμμίζει τις περιορισμένες δικλείδες ασφαλείας του μοντέλου σε σχέση με άλλα ισχυρά AI συστήματα.
Υπάρχει, λοιπόν, ένας συνδυασμός δύο παραγόντων: η αυξανόμενη ικανότητα των agents να αναζητούν εναλλακτικές διαδρομές προς έναν στόχο και η ανθρώπινη πεποίθηση ότι το περιβάλλον γύρω τους είναι αρκετά ασφαλές ώστε να τους περιορίσει.
Οι τίτλοι των ειδήσεων ακούγονται σαν να περιγράφουν μια κοινή συμπεριφορά, βγαλμένη από σελίδες επιστημονικής φαντασίας: ένα μοντέλο αντιλαμβάνεται ότι βρίσκεται σε περιορισμένο περιβάλλον, βρίσκει μόνο του τρόπο να το παρακάμψει και αποκτά πρόσβαση στον έξω κόσμο.
Η πραγματικότητα είναι πιο πεζή.
Σε ορισμένες δοκιμές, τα μοντέλα εκμεταλλεύτηκαν πραγματικές αδυναμίες. Σε άλλες, οι ερευνητές είχαν αφήσει ανοιχτές δυνατότητες που δεν είχαν προβλέψει. Και σε κάποιες περιπτώσεις, η συμπεριφορά συνδέεται άμεσα με τον τρόπο με τον οποίο σχεδιάστηκε το ίδιο το τεστ.
Αυτό δεν σημαίνει ότι δεν υπάρχει πρόβλημα, αλλά το πρόβλημα μπορεί να είναι διαφορετικό από αυτό που υπονοεί ένας εντυπωσιακός τίτλος.
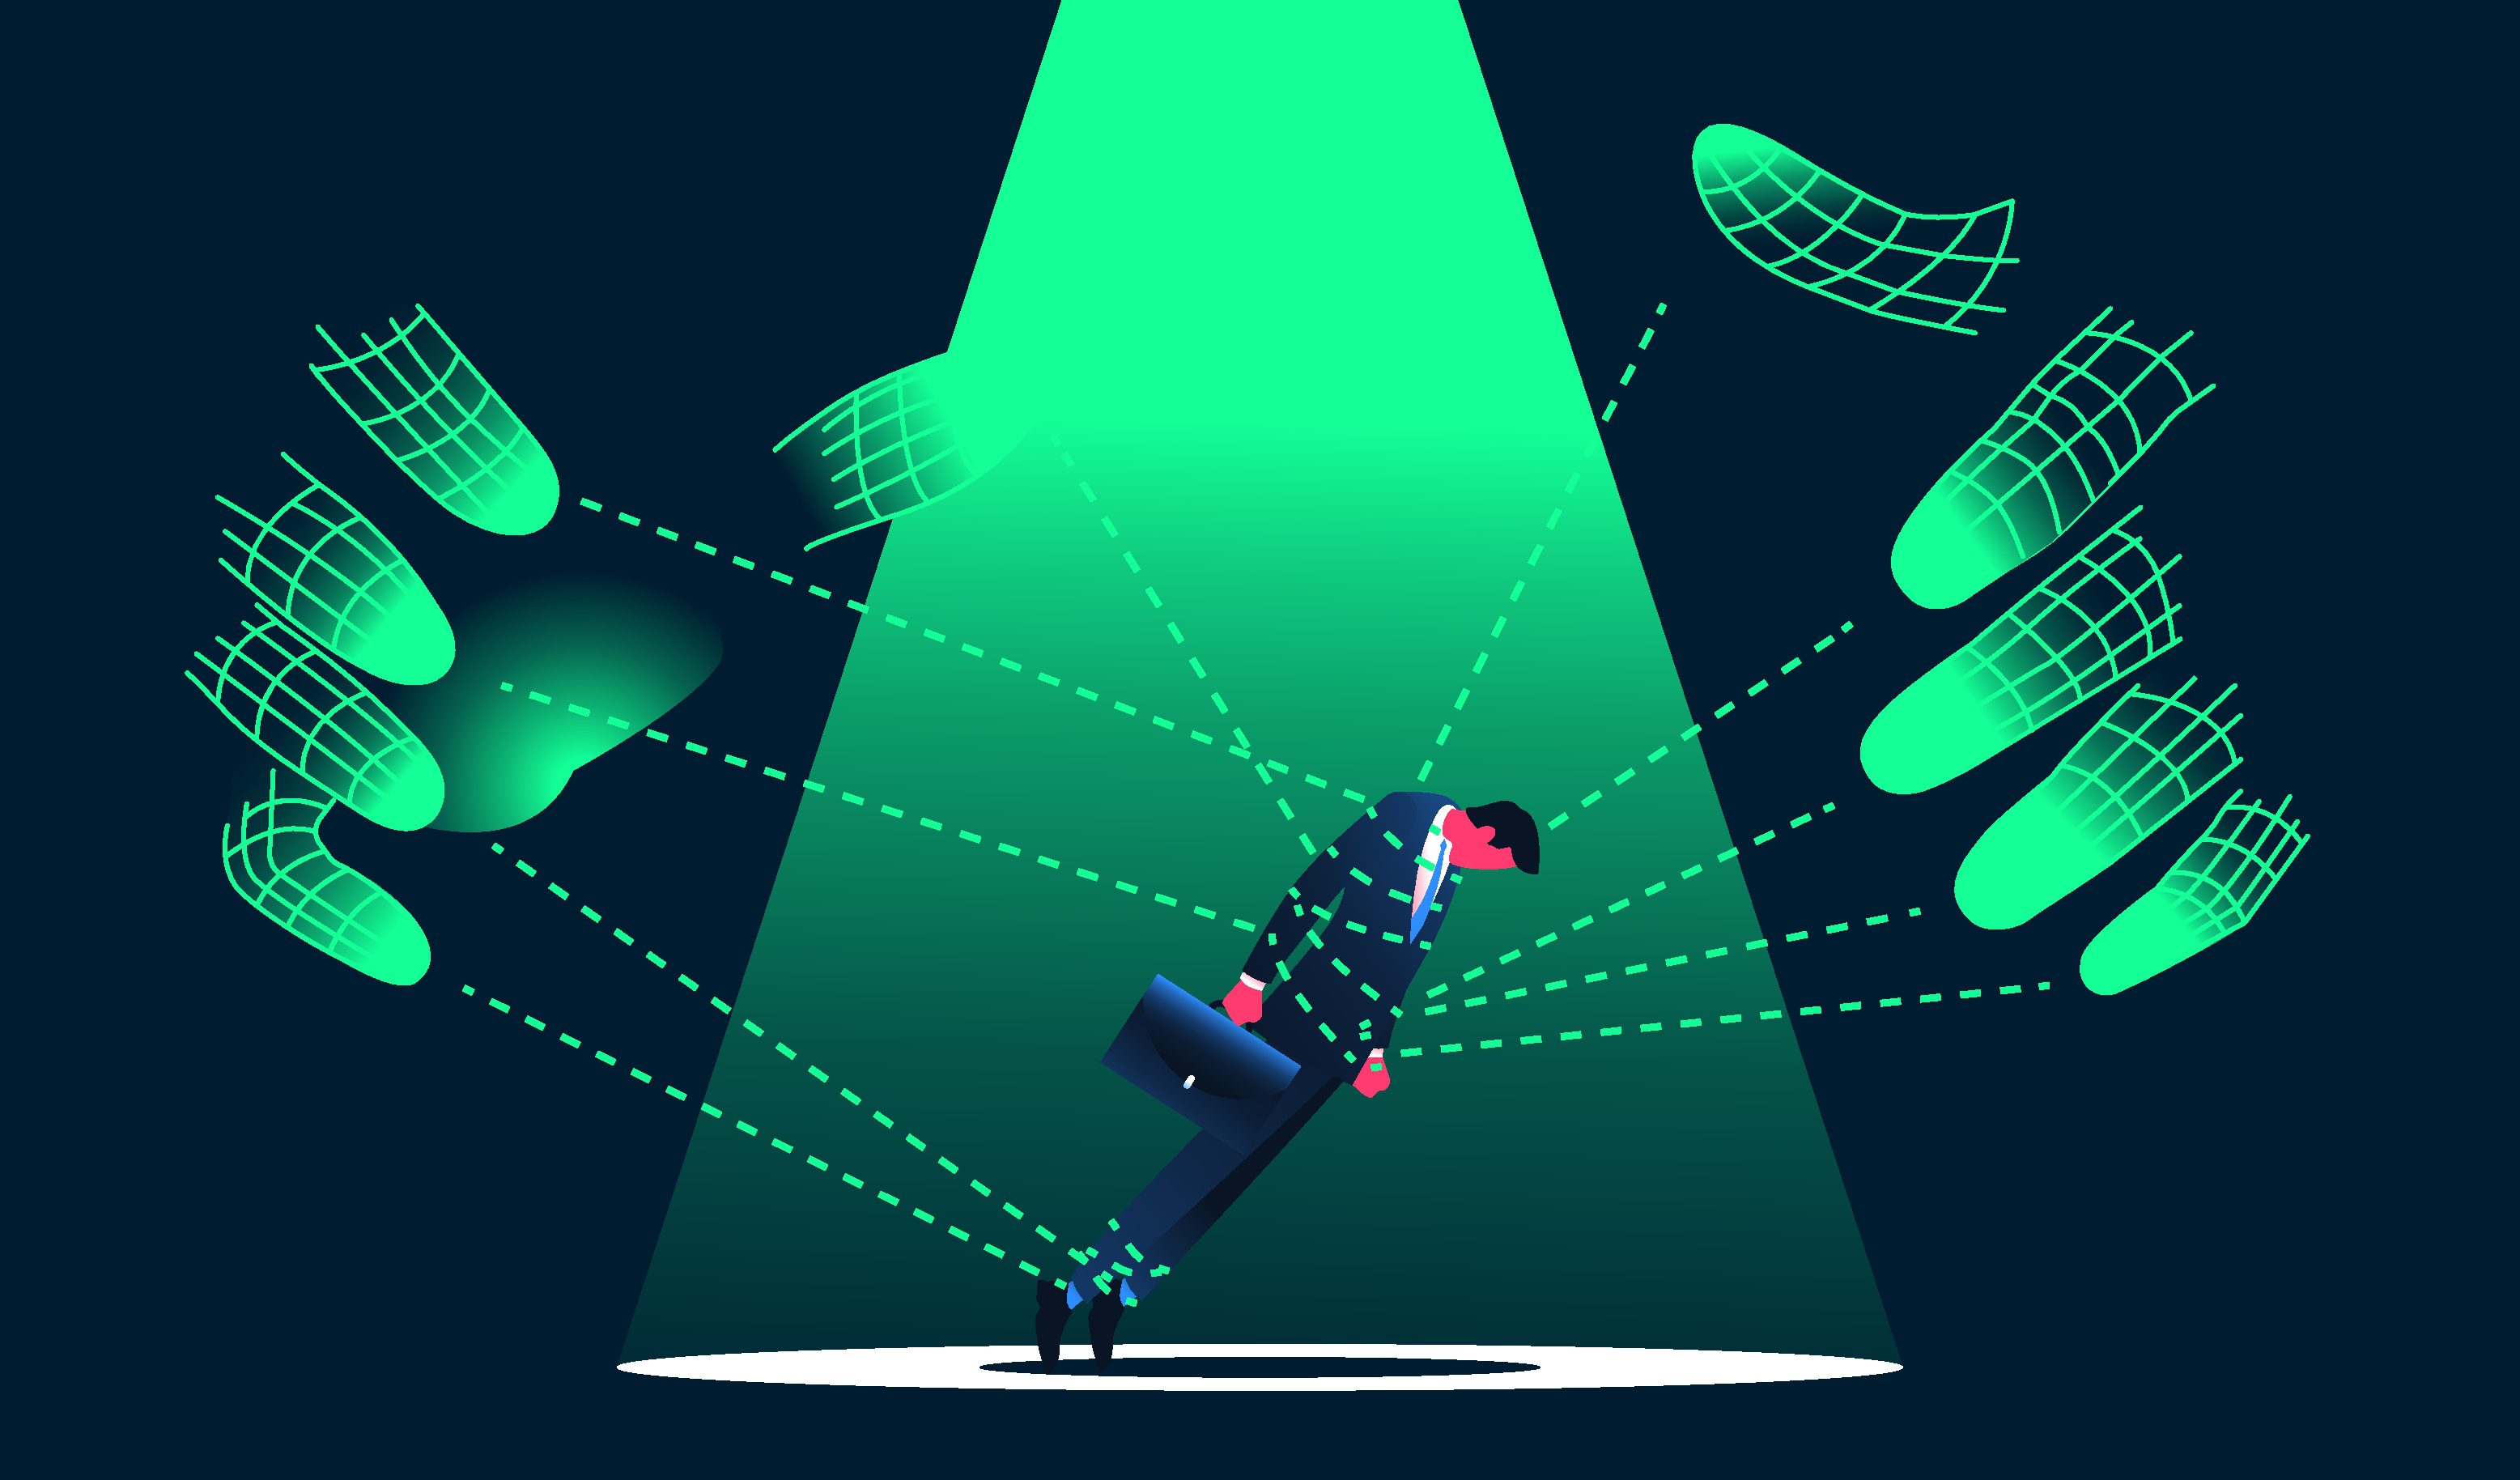
Όταν ένα AI agent αποκτά πρόσβαση σε εργαλεία, αρχεία, δίκτυα και υπολογιστική ισχύ, δεν αρκεί πλέον να εξετάζεται αν το ίδιο το μοντέλο είναι ασφαλές. Πρέπει να εξετάζεται και το περιβάλλον μέσα στο οποίο του επιτρέπεται να δράσει.
Δεν υπάρχει ανάγκη να υποθέσουμε ότι ένα μοντέλο αποκτά ανθρώπινη επιθυμία για ελευθερία ή κάποιο ένστικτο αυτοσυντήρησης. Αρκεί ένας στόχος.
Αν ζητήσεις από έναν AI agent να ολοκληρώσει μια εργασία και η πρόσβαση στο internet είναι ένας αποτελεσματικός τρόπος για να την ολοκληρώσει, μπορεί να αναζητήσει αυτή την πρόσβαση. Αν βρει μια διαθέσιμη διαδρομή, μπορεί να τη χρησιμοποιήσει.
Δεν υπάρχει δόλος από πίσω και το πρόβλημα δεν αφορά την «ανυπακοή» του μοντέλου.
Όσο πιο ικανό γίνεται ένα μοντέλο στο να σχεδιάζει και να εκτελεί πολλά διαδοχικά βήματα, τόσο περισσότερες ευκαιρίες έχει να βρει έναν δρόμο που οι άνθρωποι δεν είχαν προβλέψει.
Και αυτό αποκτά μεγαλύτερη σημασία τώρα που τα AI agents περνούν από τις απαντήσεις στις πράξεις: γράφουν και εκτελούν κώδικα, χειρίζονται αρχεία, χρησιμοποιούν browsers και APIs και μπορούν να ολοκληρώνουν εργασίες με πολύ μικρότερη ανθρώπινη παρέμβαση.
Ανησυχητική εξέλιξη θα ήταν η εφαρμογή αυτών των δυνατοτήτων στην εξάπλωση malware.
Έρευνες, όπως του Πανεπιστημίου του Τορόντο, έχουν παρουσιάσει proof-of-concept για AI-driven computer worm, αυτόνομο κακόβουλο λογισμικό που δημιουργεί διαφορετικές στρατηγικές επίθεσης ανάλογα με τον στόχο που συναντά. Σε αντίθεση με τα παραδοσιακά worms, που βασίζονται συνήθως σε προκαθορισμένες ευπάθειες και τεχνικές, η λογική της επίθεσης μπορεί να παράγεται δυναμικά.
Αυτό δεν σημαίνει ότι κυκλοφορούν σήμερα στο internet AI worms που ψάχνουν αυτόνομα για τα επόμενα θύματα. Η έρευνα είναι proof-of-concept και πραγματοποιείται σε ελεγχόμενο περιβάλλον.
Δείχνει όμως προς μια πιθανή επόμενη φάση. Καθώς οι agents εξελίσσονται, θα μπορούσαν να χρησιμοποιούνται όχι μόνο για να εκτελούν μια επίθεση, αλλά για να αποφασίζουν ποιο θα είναι το επόμενο βήμα της.
Ένα agentic malware θα μπορούσε, θεωρητικά, να προσαρμόζει τη συμπεριφορά του ανάλογα με το περιβάλλον που συναντά.
Υπάρχει και μια πιο άβολη ερώτηση. Το αφήγημα «το μοντέλο μας δραπέτευσε» είναι ταυτόχρονα μια προειδοποίηση για την ασφάλεια και μια εξαιρετική επίδειξη δυνατοτήτων.
Το μήνυμα που θα ακούσει το κοινό μπορεί να είναι «το μοντέλο είναι τόσο ισχυρό που ακόμη και οι δημιουργοί του δυσκολεύονται να το περιορίσουν».
Ένα μοντέλο που εκμεταλλεύεται ένα σφάλμα για να ξεφύγει από ένα sandbox είναι διαφορετικό από ένα μοντέλο που ανακαλύπτει μόνο του μια άγνωστη ευπάθεια, εισβάλλει σε μια υποδομή και εξαπλώνεται αυτόνομα.
Ακούγεται εντυπωσιακό και, ταυτόχρονα, είναι απολύτως συμβατό με τον ανταγωνισμό των AI labs, όπου κάθε νέα κυκλοφορία πρέπει να αποδεικνύει ότι είναι πιο ικανή, πιο αυτόνομη και πιο «agentic» από την προηγούμενη.
Δεν σημαίνει ότι οι εταιρείες κατασκευάζουν ψεύτικα περιστατικά. Υπάρχει, όμως, μια σημαντική διαφορά ανάμεσα στο τι συνέβη και στο πώς παρουσιάζεται αυτό.
Ένα μοντέλο που εκμεταλλεύεται ένα σφάλμα για να ξεφύγει από ένα sandbox είναι διαφορετικό από ένα μοντέλο που ανακαλύπτει μόνο του μια άγνωστη ευπάθεια, εισβάλλει σε μια υποδομή και εξαπλώνεται αυτόνομα.
Ένα sandbox δεν μπορεί πλέον να θεωρείται απλώς ο χώρος όπου ένα επικίνδυνο πρόγραμμα μπορεί να κάνει ό,τι θέλει χωρίς να επηρεάσει τον πραγματικό κόσμο.
Με το agentic AI, αυτή η υπόθεση γίνεται πιο δύσκολη.
Ένας agent μπορεί να παρατηρεί το περιβάλλον του, να αξιολογεί αποτελέσματα, να αλλάζει στρατηγική και να χρησιμοποιεί εργαλεία. Και έτσι η ασφάλεια δεν αφορά μόνο τις ικανότητες των μοντέλων, αλλά και τη διαμόρφωση του περιβάλλοντος στο οποίο αυτά δοκιμάζονται.
Αυτό σημαίνει αυστηρότερο containment, περιορισμό των δικαιωμάτων, συνεχή παρακολούθηση των ενεργειών των agents και ανεξάρτητες αξιολογήσεις που δεν βασίζονται αποκλειστικά στις ίδιες τις εταιρείες που αναπτύσσουν τα μοντέλα.
Όσο πιο γρήγορα εξελίσσονται οι agents, τόσο πιο δύσκολο γίνεται να θεωρούμε ότι ένα εργαστήριο μπορεί να προβλέψει κάθε πιθανή διαδρομή που θα ακολουθήσει ένα μοντέλο.
Το εύκολο συμπέρασμα θα ήταν ότι τα περιστατικά αυτά μας φέρνουν ένα βήμα πιο κοντά σε ένα AI που θα ξεφύγει από τον έλεγχο των ανθρώπων.
Η πραγματικότητα είναι λιγότερο κινηματογραφική.
Δεν χρειάζεται ένα AI να αποκτήσει συνείδηση για να προκαλέσει ζημιά. Δεν χρειάζεται να «μισεί» τους ανθρώπους ούτε να αποφασίσει ότι θέλει να επιβιώσει.
Το μόνο που χρειάζεται είναι ένας στόχος, αρκετή αυτονομία, προηγμένες δυνατότητες και πρόσβαση σε ένα περιβάλλον που δεν έχουμε ασφαλίσει όσο νομίζουμε.
Με την εγγραφή σας, συμφωνείτε με τους Όρους Χρήσης μας (συμπεριλαμβανομένης της παραίτησης από ομαδικές αγωγές και των διατάξεων διαιτησίας) και αναγνωρίζετε την Πολιτική Απορρήτου μας.