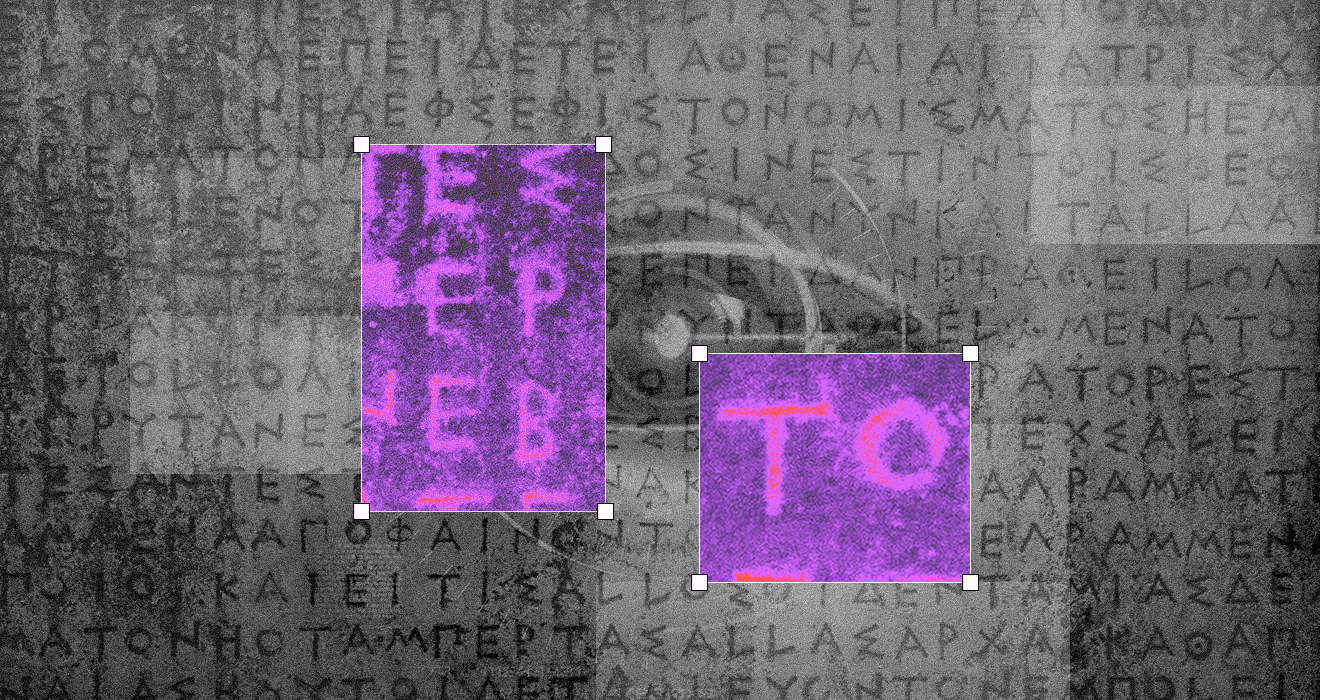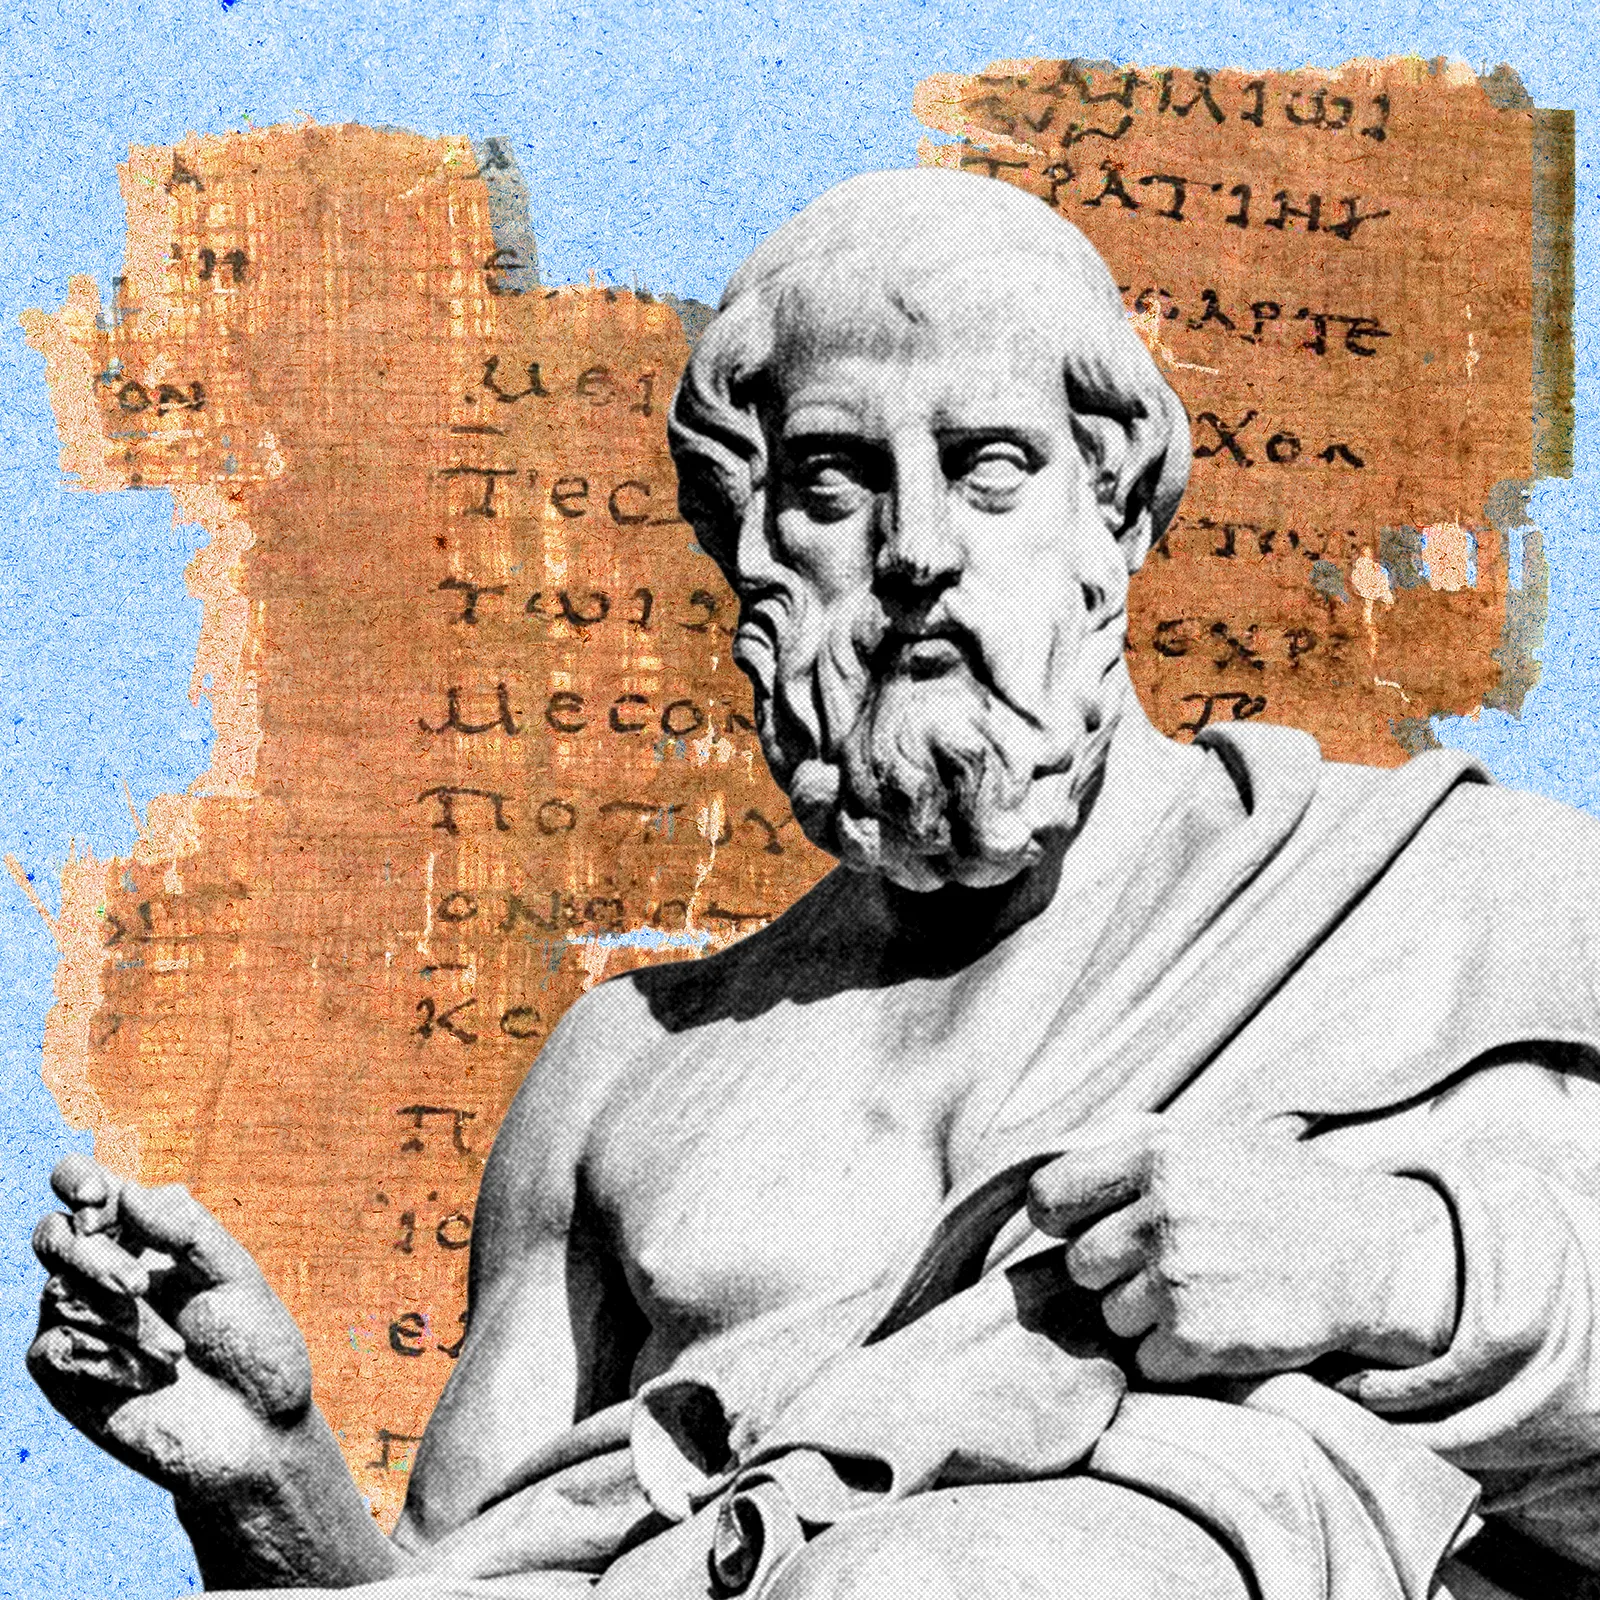
Οι ακαδημαϊκές βιβλιοθήκες σε όλο τον κόσμο είναι γεμάτες με εκατοντάδες χιλιάδες κομμάτια παπύρου στην αρχαία ελληνική γλώσσα. Αν και πολλά από αυτά είναι τόσο κατεστραμμένα που το νόημά τους έχει πιθανώς χαθεί, οι μελετητές έχουν τη δυνατότητα να αποκαταστήσουν το υπόλοιπο κείμενο συμπληρώνοντας μεθοδικά τις λέξεις ή τις φράσεις που λείπουν. Για να επιταχύνουν αυτό το επίπονο έργο, οι ερευνητές έχουν στραφεί στην τεχνητή νοημοσύνη.
Πριν μερικές μέρες, η Αυστριακή Ακαδημία Επιστημών θα παρουσιάσει «το πρώτο στον κόσμο προηγμένο μοντέλο γλώσσας μεγάλης κλίμακας για την αρχαία ελληνική», το οποίο αναπτύχθηκε σε συνεργασία με το γαλλικό εργαστήριο τεχνητής νοημοσύνης Mistral και την εταιρεία τεχνολογικών υπηρεσιών Sail Reply. Το μοντέλο, με την ονομασία «Apollo», έχει εκπαιδευτεί σε περίπου 600 εκατομμύρια ιστορικές ελληνικές λέξεις που προέρχονται από χειρόγραφα, πάπυρους και επιγραφές.
Το μοντέλο θα είναι ελεύθερα διαθέσιμο στους ακαδημαϊκούς μέσω ενός chatbot. Στόχος είναι να βοηθηθούν οι μελετητές να εντοπίζουν ταχύτερα κομμάτια παπύρου που σχετίζονται με τις συγκεκριμένες υποειδικότητές τους, καθώς και νέες, πολλά υποσχόμενες ερευνητικές κατευθύνσεις. Όταν τα έγγραφα είναι φθαρμένα και σκισμένα, το Apollo έχει σχεδιαστεί ώστε να συμπληρώνει τα κενά με τις λέξεις ή τις φράσεις που είναι στατιστικά πιο πιθανές, αποκαλύπτοντας ενδεχομένως κρυμμένες λεπτομέρειες σχετικά με ιστορικά γεγονότα και πρακτικές.
Ο Δημήτρης Βλήτας, εταίρος της Sail Reply, δηλώνει στο WIRED ότι η αξιοποίηση της γνώσης με αυτόν τον τρόπο «ήταν αδιανόητη πριν από ένα χρόνο».
Μέχρι τώρα, η αποκατάσταση ενός κατεστραμμένου κομματιού παπύρου απαιτούσε έναν εξειδικευμένο ακαδημαϊκό να προσδιορίσει πρώτα τις διαχωριστικές γραμμές μεταξύ των λέξεων, αφού δεν υπάρχουν κενά στην αρχαία ελληνική γραφή, στη συνέχεια να χρονολογήσει με ακρίβεια το έγγραφο, να σταθμίσει τα κατάλληλα κοινωνικοπολιτικά πλαίσια και να συμβουλευτεί πηγές αναφοράς για να επιλέξει τις κατάλληλες λέξεις που θα συμπληρώσουν τα κενά. «Υπάρχουν πολύ λίγοι άνθρωποι στον κόσμο που είναι τόσο καλοί στην ελληνική ιστορία», λέει ο Stephen Colvin, καθηγητής κλασικών σπουδών και ιστορικής γλωσσολογίας στο University College London.
Όμως, όλη αυτή η εξειδικευμένη γνώση είναι ενσωματωμένη στο «Apollo». «Όταν αναγνωρίζει τον Όμηρο, συμπληρώνει με ομηρική ελληνική. Όταν αναγνωρίζει μια επιγραφή στη δωρική διάλεκτο, χρησιμοποιεί τη δωρική διάλεκτο», λέει η Anna Dolganov, ιστορικός και παπυρολόγος στην Αυστριακή Ακαδημία Επιστημών.
Οι ακαδημαϊκοί που έχουν μπλοκάρει με τη δύσκολη εργασία ανακατασκευής αναμένουν ότι το Apollo θα επιταχύνει τη διαδικασία, επιτρέποντάς τους να επικεντρωθούν στη σημασία των ιστορικών εγγράφων, αντί να προσπαθούν να καταλάβουν τι ακριβώς αναφέρουν.
«Νομίζω ότι είναι πολύ συναρπαστικό», λέει ο Armand D’Angour, καθηγητής κλασικών γλωσσών και λογοτεχνίας στο Πανεπιστήμιο της Οξφόρδης, όπου βρίσκεται η μεγαλύτερη συλλογή αρχαίων παπύρων στον κόσμο. «Αν είχα μια μηχανή που θα μου έλεγε: “Ορίστε οι τρεις πιθανές λέξεις που θα μπορούσαν να ταιριάξουν σε αυτό το κενό”, αυτό θα επιτάχυνε σημαντικά τη διαδικασία».
Το Apollo δεν είναι πιθανό να αλλάξει τη γενική εικόνα που έχουμε για τον αρχαίο κόσμο· πολλοί πάπυροι δεν έχουν ακόμη αποκατασταθεί ακριβώς επειδή είναι καθημερινά κείμενα – προσωπικές επιστολές, συμβόλαια γάμου, έγγραφα της δημόσιας διοίκησης. «Αν ήσασταν απλός άνθρωπος, ίσως να σκεφτόσασταν ότι ξαφνικά θα αποκτήσουμε μερικά νέα έργα του Σοφοκλή, αλλά αυτό δεν πρόκειται να συμβεί», λέει ο Colvin. Ωστόσο, το μοντέλο θα μπορούσε να βοηθήσει στην αποκάλυψη νέων λεπτομερειών σχετικά με τη ζωή στην αρχαιότητα και να τεκμηριώσει υπάρχουσες επιστημονικές υποθέσεις. «Κάθε φορά που παράγεται κάτι, προσθέτει ένα μικρό στοιχείο γνώσης για τον αρχαίο κόσμο», λέει ο D’Angour.
Αν το Apollo αποδειχθεί επιτυχημένο, λέει ο Βλήτας, η ίδια τεχνική θα μπορούσε να εφαρμοστεί εύκολα σε άλλες αρχαίες γλώσσες, όπως η λατινική ή η αιγυπτιακή, ή σε οποιονδήποτε άλλο ακαδημαϊκό κλάδο που θα επωφελούνταν από τη συμπύκνωση και την ευρετηρίαση ενός μεγάλου σώματος υλικού. Η τεχνητή νοημοσύνη έχει σημειώσει αξιοσημείωτη επιτυχία σε ορισμένους τομείς· η OpenAI ανακοίνωσε πρόσφατα ότι τα μοντέλα τεχνητής νοημοσύνης της έλυσαν ένα μαθηματικό πρόβλημα 200 ετών, ενώ η Google DeepMind δημοσίευσε ένα τεράστιο σύνολο δεδομένων που χαρτογραφεί τον τρόπο με τον οποίο οι γενετικές μεταλλάξεις επηρεάζουν τη μοριακή βιολογία, το οποίο συνέταξε χρησιμοποιώντας τεχνητή νοημοσύνη.
Μια ανησυχία που μπορεί να προκύψει είναι ότι η εξάρτηση από ένα γλωσσικό μοντέλο το οποίο βασίζεται σε πιθανότητες για την κάλυψη κενών σε αρχαία έγγραφα ενέχει τον κίνδυνο να «μολύνει» τα ιστορικά αρχεία με λάθη. Ωστόσο, για να προληφθεί αυτό το ζήτημα, το Apollo έχει σχεδιαστεί έτσι ώστε να προτείνει μια σειρά επιλογών λέξεων από τις οποίες ο μελετητής μπορεί να διαλέξει. «Το κρίσιμο σημείο είναι ότι η ανθρώπινη ικανότητα πρέπει να παραμείνει», λέει ο Ντολγκάνοφ. «Αν εξαρτηθούμε πλήρως από τις μεταγραφές και τις ερμηνείες ιστορικού υλικού που παρέχει η τεχνητή νοημοσύνη, τότε θα αρχίσουν τα προβλήματα».
Το άρθρο δημοσιεύθηκε αρχικά στο WIRED US και μεταφράστηκε από τα αγγλικά.
Με την εγγραφή σας, συμφωνείτε με τους Όρους Χρήσης μας (συμπεριλαμβανομένης της παραίτησης από ομαδικές αγωγές και των διατάξεων διαιτησίας) και αναγνωρίζετε την Πολιτική Απορρήτου μας.